클라우드 AI 에이전트를 부업이나 업무에 쓰다 보면 “이 파일, 이 대화 내용이 어딘가 서버에 계속 쌓이고 있겠지”라는 찜찜함이 한 번쯤 들기 마련입니다. 결론부터 말씀드리면, 메타(Meta)가 2026년 8월 10일 공개한 오픈웨이트 로컬 에이전트 모델 ‘뮤즈 글리머(Muse Glimmer)’는 30B(300억) 파라미터 모델을 소비자용 GPU 한 장에 올려서, 인터넷 연결이나 월 구독료 없이 내 컴퓨터 안에서 에이전트 작업을 돌릴 수 있게 해주는 모델입니다.
이 글은 앞서 다룬 메타 뮤즈 글리머 공개, 소비자용 GPU로 돌리는 로컬 AI 에이전트가 갖는 의미 뉴스 글의 후속 실전편입니다. 그 글에서 “왜 이 모델이 중요한지”를 다뤘다면, 이번 글에서는 실제로 무엇을 준비하고, 어떤 순서로 다운로드·실행해야 하는지를 공식 문서 기준으로 단계별 정리했습니다.
핵심 요약(TL;DR)
- 뮤즈 글리머는 약 296억 파라미터 규모의 오픈웨이트 모델로, Apache 2.0 라이선스로 허깅페이스(Hugging Face)에 공개됐습니다. 4비트 양자화(GGUF) 기준 17~19GB 안팎의 VRAM만 있으면 RTX 4090 같은 소비자용 GPU 한 장으로 구동됩니다.
- 가장 쉬운 실행 경로는 LM Studio에서 모델을 검색해 내려받는 방식이고, 커맨드라인에 익숙하다면 llama.cpp로 직접 빌드해 GGUF 파일을 돌리는 방법도 있습니다.
- 최소 사양은 RAM 26GB 이상이며, 24GB급 GPU에서는 4비트 양자화(Q4_K_XL 계열), 32GB급 GPU에서는 정확도 손실이 더 적은 K-Quant-Dynamic 양자화를 권장합니다.
준비물 확인하기 — 내 컴퓨터로 돌릴 수 있을까
뮤즈 글리머는 ‘가벼운 모델’은 아니지만, 300억 파라미터급 치고는 이례적으로 소비자용 하드웨어를 정조준해 설계됐습니다. 허깅페이스 공식 블로그에 따르면 28B 규모의 텍스트 디코더가 52개 레이어(슬라이딩 윈도우 어텐션 3개 + 풀 어텐션 1개 패턴을 13번 반복)로 구성돼 있고, 여기에 약 20억 파라미터 규모의 이미지 인식용 퍼셉션 인코더(ViT-G/14 스타일, 50개 레이어)가 함께 붙어 있어 텍스트뿐 아니라 이미지 입력도 함께 처리할 수 있습니다.
- GPU VRAM: 풀 정밀도(BF16)는 55GB 이상이 필요하지만, 4비트 양자화 버전은 17~19GB면 충분합니다. RTX 3090·4090·5090처럼 VRAM 24GB급 카드가 현실적인 기준선입니다.
- 시스템 RAM: LM Studio 공식 가이드는 가장 작은 양자화 버전 기준 최소 26GB RAM을 권장합니다.
- 맥(Mac) 사용자: 메타는 M4 Max·M5 Max 등 유니파이드 메모리가 넉넉한 맥 환경에서도 테스트를 마쳤다고 밝혔습니다. 통합 메모리 32GB 이상이면 시도해볼 만합니다.
- AMD 사용자: AMD 공식 블로그는 Ryzen AI Max+ 프로세서 기반 PC나 Radeon AI PRO R9700(32GB) 그래픽카드를 ‘바로 돌아가는’ 추천 사양으로 안내하고 있습니다.
- 컨텍스트 길이: 최대 131,072 토큰(양자화 빌드에 따라 그 이상)까지 지원해, 긴 코드베이스나 문서를 통째로 넣고 작업을 맡기기에도 여유가 있습니다.
정리하면, VRAM 24GB급 그래픽카드(RTX 3090 이상) 또는 통합 메모리 32GB 이상 맥이 있다면 대부분 시도해볼 수 있는 사양입니다. 그 아래 사양이라면 2비트(UD-Q2_K_XL, 12~14GB) 같은 더 낮은 양자화 옵션도 있지만 정확도 손실이 커지는 점은 감안해야 합니다.
다운로드 방법 — LM Studio로 쉽게, llama.cpp로 직접
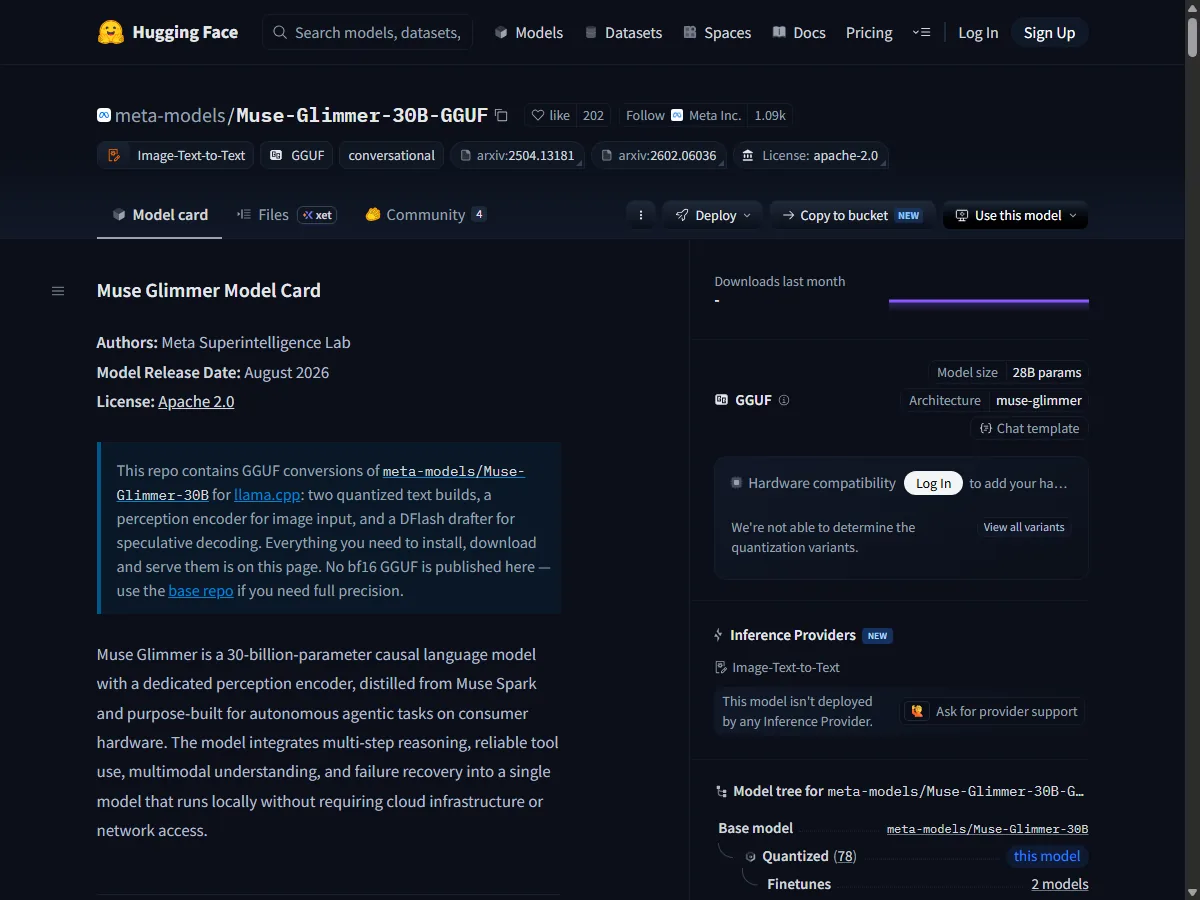
뮤즈 글리머는 허깅페이스의 meta-models 저장소에서 GGUF 형식으로 공식 배포되고 있고, Ollama·LM Studio·Unsloth·vLLM·SGLang 등 주요 로컬 실행 도구에서 바로 불러올 수 있습니다. 초보자라면 GUI 도구인 LM Studio, 세부 설정을 직접 조정하고 싶다면 llama.cpp를 추천합니다.
방법 1. LM Studio로 원클릭 실행 (초보자 추천)
- LM Studio 공식 사이트에서 프로그램을 내려받아 설치합니다.
- LM Studio를 실행한 뒤 검색창에 ‘Muse Glimmer’를 입력합니다. 메타가 LM Studio와 출시일 기준으로 파트너십을 맺어, 별도 링크 없이 프로그램 안에서 바로 검색·다운로드가 가능합니다.
- 본인 GPU의 VRAM 용량에 맞는 양자화 버전을 선택합니다(24GB면 Q4 계열, 32GB 이상이면 더 높은 정확도의 K-Quant-Dynamic).
- 다운로드가 끝나면 ‘Load Model’ 버튼으로 모델을 불러오고, 채팅창에서 바로 대화나 에이전트 작업을 시작할 수 있습니다.
방법 2. llama.cpp로 직접 빌드하기 (숙련자용)
Unsloth 공식 문서가 안내하는 절차를 정리하면 다음과 같습니다. llama.cpp는 b10353 이상 빌드부터 뮤즈 글리머를 지원합니다.
- llama.cpp 저장소를 내려받고 GPU(CUDA) 지원으로 빌드합니다.
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j - 허깅페이스 허브 도구를 설치하고 양자화 모델 파일을 내려받습니다.
pip install huggingface_hub
hf download unsloth/Muse-Glimmer-30B-GGUF --local-dir Muse-Glimmer-30B-GGUF --include "*UD-Q4_K_XL*" - 다운로드한 GGUF 파일을 llama-cli로 실행합니다.
./llama.cpp/llama-cli --model Muse-Glimmer-30B-GGUF/Muse-Glimmer-30B-UD-Q4_K_XL.gguf --temp 1.0 --top-p 0.95 --top-k 64
세 번째 단계의 temp 1.0, top-p 0.95, top-k 64 값은 메타가 공식 문서에서 권장하는 기본 샘플링 설정이므로, 처음 실행할 때는 그대로 두는 것을 권장합니다.
실행하고 성능 확인하기
뮤즈 글리머는 DFlash라는 추측 디코딩(speculative decoding) 기술을 함께 제공합니다. 한 번에 16개 토큰 블록을 예측한 뒤 본 모델이 병렬로 검증하는 방식으로, 품질 저하 없이 응답 속도를 최대 3.1배까지 끌어올린다고 메타는 설명합니다.
실제 벤치마크 사례도 참고할 만합니다. RTX 4090에서 Q4_K_XL 양자화로 13만 토큰 컨텍스트를 처리했을 때 VRAM 19.34GB 사용, 프리필(prefill) 초당 약 3,135토큰, 디코드 초당 약 50토큰이 나왔다는 벤치마크가 공유된 바 있습니다. 실제 체감 속도는 GPU 세대, 드라이버, 컨텍스트 길이에 따라 달라질 수 있으니 참고 수치로만 봐 주세요.
실행 중 막히기 쉬운 지점 두 가지도 미리 알아두면 시행착오를 줄일 수 있습니다.
- 첫 실행 시에는 짧은 프롬프트로 정상 로딩·응답 여부를 먼저 확인하는 것이 안전합니다.
- 이미지 입력을 쓰려면 별도의 mmproj(퍼셉션 인코더) 파일도 함께 내려받아 연결해야 멀티모달 기능이 작동합니다.
- VRAM 부족(OOM) 오류:
cudaMalloc failed: out of memory나ggml_backend_cuda_buffer_type_alloc_buffer: allocating ... failed같은 메시지가 뜨면 GPU 메모리가 모자란 상태입니다. 한 단계 낮은 양자화(Q4 → Q2)로 바꾸거나,-c 4096처럼 컨텍스트 길이를 줄이고--mlock옵션은 빼는 것이 첫 번째 대응입니다. - 버전 불일치 오류: llama.cpp가 b10353보다 오래된 빌드면
unknown model architecture또는unrecognized tensor같은 메시지와 함께 모델 로딩이 즉시 실패합니다. 이 경우 llama.cpp 저장소를 최신으로 pull받아 다시 빌드하면 해결됩니다.
직접 해보니 — 공식 문서를 끝까지 따라가며 확인한 것
정직하게 말씀드리면, 이 글을 쓰는 데 사용한 노트북에는 별도 GPU가 없어서 뮤즈 글리머를 실제로 로컬에서 구동해보지는 못했습니다. 대신 메타 공식 발표, 허깅페이스 저장소, LM Studio·Unsloth·AMD의 공식 설치 문서를 처음부터 끝까지 순서대로 따라가며 링크와 명령어가 실제로 안내하는 대로 이어지는지 확인했습니다.
이 과정에서 걸림돌로 느낀 점은 크게 두 가지였습니다.
- 같은 ‘30B 모델’이라도 배포처(meta-models·bartowski·unsloth·lmstudio-community)마다 양자화 파일 이름과 권장 VRAM 수치가 조금씩 달라서, 어떤 저장소의 어떤 파일을 받아야 하는지 처음엔 헷갈렸습니다.
- llama.cpp 경로는 빌드 버전(b10353 이상)을 맞추지 않으면 모델을 인식하지 못한다는 안내가 있어, 이미 llama.cpp를 설치해둔 분이라면 업데이트부터 먼저 해야 한다는 점을 눈여겨봐야 했습니다.
반대로 LM Studio 경로는 문서상으로는 검색 → 다운로드 → 로드까지 절차가 단순했습니다. GPU 사양만 맞는다면 진입장벽이 낮아 보였습니다.
실전 활용 아이디어 — AI 부업·생산성에 연결하기
범용 로컬 LLM과 달리 뮤즈 글리머는 함수 호출(tool calling) 네이티브 지원, 최대 131,072 토큰의 긴 컨텍스트, ViT-G/14 기반 이미지 인식 퍼셉션 인코더라는 세 가지 특징을 처음부터 에이전트 용도로 갖추고 나왔습니다. 이 특징들을 각각 어떤 부업·업무 상황에 붙일 수 있는지로 좁혀서 정리했습니다.
- MCP·n8n으로 로컬 완결형 자동화를 만드는 분: 뮤즈 글리머는 함수 호출을 하도록 학습된 모델이라, MCP 서버 연결해서 AI 에이전트 실전 활용하는 법에서 다룬 방식대로 로컬 파일 시스템·터미널 명령을 실행하는 MCP 서버와 붙이면, 클라우드 API 호출 없이 ‘파일 정리 → 실행 → 결과 확인’까지 컴퓨터 안에서만 끝나는 워크플로우를 만들 수 있습니다.
- 계약서·긴 코드베이스를 통째로 검토하는 프리랜서·개발자: 131,072 토큰 컨텍스트는 웬만한 코드 저장소나 수십 페이지짜리 계약서·보고서를 통째로 넣을 수 있는 크기입니다. 문서를 잘라서 나눠 넣을 필요 없이 한 번에 맡기면서도, 외부 서버 업로드 없이 로컬에서만 처리할 수 있다는 점이 핵심입니다.
- 영수증·제품 사진·스캔 문서를 다루는 자동화 부업러: 내장된 ViT-G/14 퍼셉션 인코더 덕분에 별도의 OCR API나 이미지 인식 API를 따로 연결하지 않아도 이미지와 텍스트를 한 프롬프트에 함께 넣어 처리할 수 있습니다. 영수증 정리, 상품 사진 태깅·설명문 생성 같은 반복 작업을 로컬에서 무료로 자동화하는 데 적용해볼 만합니다.
- 대량 배치 작업의 API 비용을 줄이려는 자동화 부업러: DFlash 추측 디코딩으로 응답 속도가 최대 3.1배 빨라지는 만큼, 텍스트 분류·태깅·1차 요약처럼 건수가 많은 반복 작업을 로컬에서 처리하고 최종 검수나 고난도 판단만 클라우드 AI로 넘기는 하이브리드 파이프라인을 구성하면 토큰당 과금되는 API 비용을 줄일 수 있습니다.
에이전틱 AI란 무엇인가에서 다룬 ‘목표만 주면 여러 단계를 알아서 처리하는’ 에이전트의 특성을, 이제는 클라우드 구독 없이도 로컬에서 시험해볼 수 있게 된 셈입니다.
자주 묻는 질문
뮤즈 글리머는 완전히 무료인가요?
모델 가중치 자체는 Apache 2.0 라이선스로 공개돼 있어 다운로드와 상업적 활용에 별도 비용이 들지 않습니다. 다만 이를 구동할 GPU나 클라우드 GPU 임대 비용은 별도이므로, ‘API 요금은 없지만 하드웨어 비용은 있다’고 이해하시는 것이 정확합니다.
GPU가 없는데 CPU만으로도 돌아가나요?
llama.cpp는 CPU 전용 빌드도 지원하지만, 300억 파라미터급 모델을 CPU로만 돌리면 속도가 매우 느려져 실용적인 에이전트 작업에는 적합하지 않습니다. 최소한 통합 메모리 32GB 이상인 맥이나 VRAM 24GB급 GPU를 권장합니다.
클라우드 API로 쓰는 챗GPT·클로드와 비교하면 성능은 어떤가요?
메타는 공식 발표에서 에이전틱·코딩·멀티모달·안전성 등 여러 벤치마크에서 비슷한 체급의 오픈웨이트 모델과 경쟁력 있는 결과를 보였다고 밝히고 있습니다. 다만 최상위 클라우드 모델과 동급의 범용 성능을 기대하기보다는, ‘로컬에서 데이터 유출 없이, 비용 없이 돌아가는 실용적인 에이전트’라는 목적에 맞춰 판단하는 것이 현실적입니다.
양자화(Quantization)가 뭔가요? 꼭 해야 하나요?
양자화는 모델 가중치의 정밀도를 낮춰 파일 크기와 필요 VRAM을 줄이는 압축 기법입니다. 풀 정밀도(55GB 이상)로 돌릴 수 있는 소비자용 GPU는 사실상 없기 때문에, 대부분의 사용자는 4비트 양자화(Q4 계열) 버전을 사용하게 되며 메타 공식 문서도 이를 기본 권장값으로 안내하고 있습니다.
핵심 요약
- 메타의 뮤즈 글리머(30B)는 Apache 2.0 오픈웨이트로 공개된 로컬 에이전트 모델로, 4비트 양자화 기준 VRAM 17~19GB(RTX 4090급)면 소비자용 PC 한 대에서 구동할 수 있습니다.
- 초보자는 LM Studio에서 모델을 검색해 내려받는 방식이 가장 쉽고, llama.cpp로 직접 빌드하면 샘플링 설정(temp 1.0·top-p 0.95·top-k 64)까지 세밀하게 조정할 수 있습니다.
- 실제 GPU가 없어 직접 구동 테스트는 못 했지만, 공식 문서를 끝까지 확인한 결과 배포처별 양자화 파일명 차이와 llama.cpp 빌드 버전(b10353 이상) 요건은 미리 확인해두는 것이 좋습니다.



AI 리서치와 검수 과정을 거쳐 콘텐츠를 제작합니다. 오류나 개선할 점을 발견하시면 연락처로 알려주세요.