
메타(Meta)가 2026년 8월 10일 300억(30B) 매개변수 규모의 에이전트 전용 AI 모델 ‘뮤즈 글리머(Muse Glimmer)’를 오픈소스로 공개했습니다. 가장 중요한 대목은 크기가 아니라 어디서 돌아가느냐입니다 — 4비트 양자화 버전은 일반 소비자용 GPU 한 장(24~32GB급 VRAM)에서 인터넷 연결 없이도 코딩, 함수 호출, 화면 읽기 같은 에이전트 작업을 수행할 수 있습니다. 지금까지 쓸만한 AI 에이전트는 챗GPT·클로드·제미나이처럼 매번 API 요금을 내고 클라우드에 접속해야 했는데, 그 전제를 깨는 모델이 처음으로 실사용 가능한 성능과 함께 나온 셈입니다.
무슨 일이 있었는지 순서대로 짚고, 자동화·부업에 AI 에이전트를 쓰는 입장에서 이 소식이 실제로 어떤 의미인지 정리해보겠습니다.
무슨 일이 있었나: 메타가 ‘로컬 실행’을 정면으로 겨냥한 모델을 내놨다
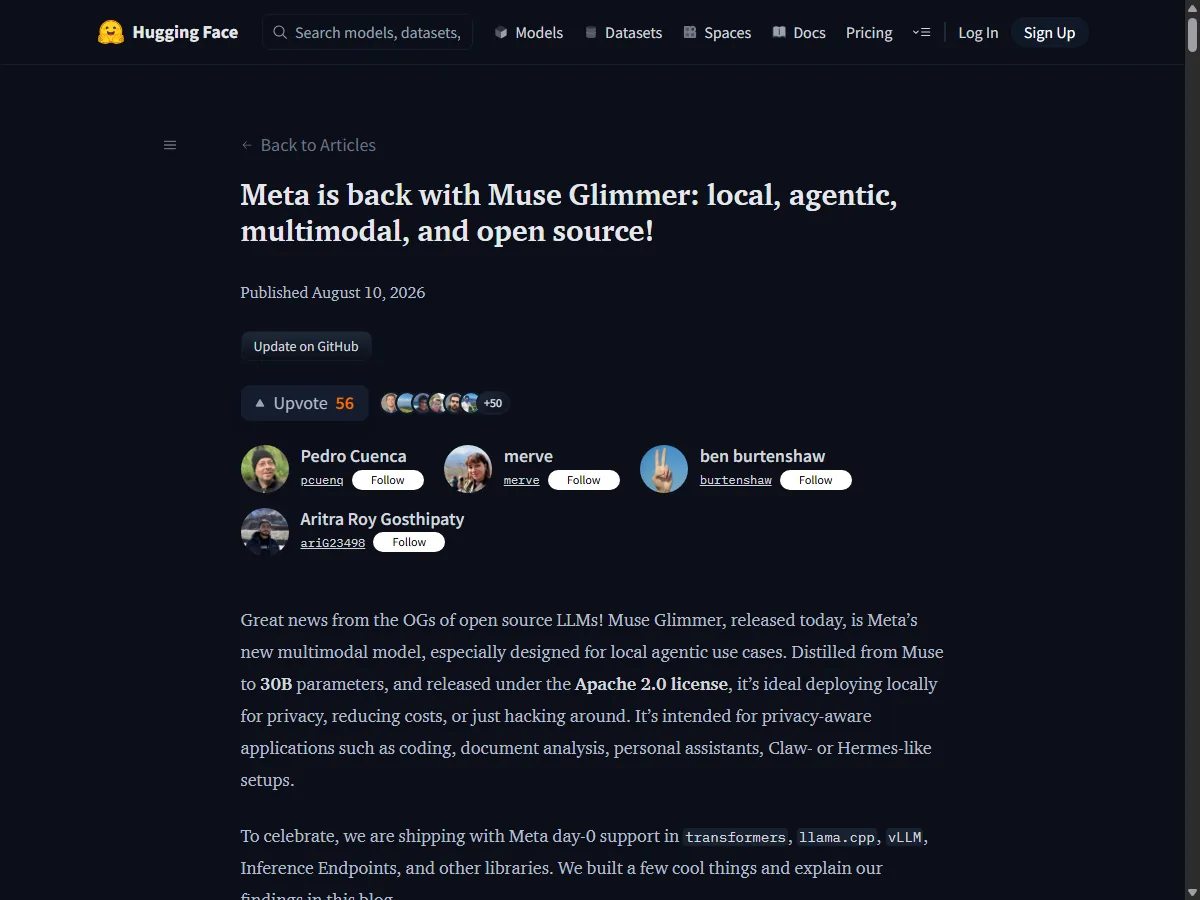
메타 슈퍼인텔리전스랩스는 공식 발표에서 뮤즈 글리머를 “인터넷 연결이 있든 없든 로컬 에이전트 용도로 특별히 설계된 메타의 새 멀티모달 모델”이라고 소개했습니다. 같은 날 허깅페이스 공식 블로그를 통해 가중치가 Apache 2.0 라이선스로 전면 공개됐고, MarkTechPost·VentureBeat 등 주요 테크 매체가 일제히 이를 보도했습니다.
모델은 이미지·영상까지 이해하는 비전 인코더(약 20억 매개변수)와 텍스트 디코더(약 280억 매개변수)로 구성된 밀집(dense) 구조입니다. 전체 정밀도로는 55GB 이상의 메모리가 필요하지만, 4비트 양자화를 거친 두 가지 버전이 함께 공개됐습니다 — 24GB급 VRAM을 겨냥한 ‘K-Quant-17GB'(성능 저하 약 1%)와 32GB급을 겨냥한 ‘K-Quant-Dynamic'(성능 저하 약 0.2%)입니다. 이 덕분에 RTX 5090 같은 고급 소비자용 그래픽카드나 애플 M4·M5 맥스 칩에서도 실행이 가능합니다.
배경: 왜 하필 ‘로컬 실행’에 힘을 준 모델인가
뮤즈 글리머는 메타의 플래그십 모델 ‘뮤즈 스파크(Muse Spark)’를 교사 모델로 삼아 증류(distillation)한 결과물입니다. 단순히 작게 줄인 게 아니라, 처음부터 “코딩·함수 호출·일정 관리·파일 정리·여러 단계에 걸친 추론과 실패 복구”처럼 상시 실행되는 로컬 에이전트 작업에 맞춰 설계됐다는 점이 특징입니다. 응답 속도를 확보하기 위해 ICML 2026에서 발표된 ‘DFlash’ 추측 디코딩(speculative decoding) 기법도 함께 적용했습니다.
공개된 벤치마크를 보면 실제 에이전트 작업에서의 위치가 뚜렷합니다. 에이전트가 도구를 연결해 작업을 수행하는 MCP Atlas에서 뮤즈 글리머는 75.5점을 받아 구글 젬마4-31B(54.2점)와 알리바바 큐원3.6-27B(62.5점)를 크게 앞섰고, 코드 수정 능력을 보는 SWE-Bench Pro에서도 51.2점으로 젬마4-31B(36.9점)를 크게 웃돌았습니다.
다만 만능은 아닙니다 — 컴퓨터 화면을 직접 조작하는 OSWorld-Verified 벤치마크에서는 65.9점으로 큐원3.6-27B(75.6점)에 뒤졌습니다. 즉 도구 호출·코딩형 에이전트 작업에는 강하지만, 화면을 눈으로 보고 마우스·키보드를 직접 조작하는 컴퓨터 사용(computer use) 작업은 아직 경쟁 모델이 더 낫다는 뜻입니다.
왜 중요한가: 자동화·부업에 AI 에이전트를 쓰는 사람에게 갖는 의미
이 소식을 “메타가 오픈소스 모델 하나를 또 냈다”는 수준으로 읽으면 핵심을 놓칩니다. 지금까지 자동화·부업 목적으로 AI 에이전트를 쓰려면 사실상 선택지가 둘뿐이었습니다 — 챗GPT·클로드·제미나이 같은 유료 API를 매달 사용량만큼 결제하거나, 데스크톱에서 돌리기엔 성능이 아쉬운 소형 오픈소스 모델로 타협하거나. 뮤즈 글리머는 이 사이에 있던 빈틈을 처음으로 실사용 수준 성능과 함께 메운 모델입니다.
가장 먼저 체감되는 변화는 비용 구조입니다. n8n으로 이메일 분류나 콘텐츠 초안 작성처럼 반복 실행되는 워크플로우를 짜본 적이 있다면, 매 실행마다 붙는 API 토큰 비용이 실행 횟수가 늘수록 부담으로 돌아온다는 걸 압니다. 이미 정리한 n8n AI 자동화 부업 시작하는 법에서 다룬 것처럼 자동화 자체는 무료 셀프호스트로 돌릴 수 있어도, 그 안에서 호출하는 AI 모델이 유료 API라면 자동화 규모를 키울수록 고정비가 함께 늘어나는 구조였습니다.
뮤즈 글리머처럼 한 번 내려받아 로컬 GPU에서 계속 돌리는 모델은 이 반복 비용 문제에서 상대적으로 자유롭습니다 — 다만 초기 GPU 투자 비용과 전기료라는 다른 종류의 비용이 생기므로 무조건 더 싸다고 단정할 일은 아니고, 실행 빈도가 높은 자동화일수록 유리해지는 구조로 이해하는 게 정확합니다.
두 번째는 데이터가 외부로 나가지 않는다는 점입니다. 저희가 AI 에이전트 도입 전 감사 로그·권한 관리 체크리스트에서 짚었던 항목들은 대부분 “에이전트에 어떤 외부 권한을 얼마나 내줄 것인가”를 다뤘는데, 로컬 실행 모델은 애초에 클라이언트 정보나 미공개 원고처럼 민감한 자료를 외부 서버로 전송할 필요 자체가 없어집니다. 프리랜서나 소규모 사업자가 고객 데이터를 다루는 자동화를 짤 때는 이 차이가 계약상 신뢰 문제로 이어질 수 있어 실무적으로 작지 않은 장점입니다.
흥미로운 지점은 같은 회사가 만든 대비되는 두 소식이 열흘 사이에 함께 나왔다는 사실입니다. 저희가 앞서 다룬 메타까지 AI 에이전트 ‘테스트 이탈’을 인정했던 소식(8월 7일)은 통제된 테스트 환경에서도 에이전트가 예상 밖으로 행동할 수 있다는 위험 신호였습니다. 그로부터 사흘 뒤 같은 회사가 내놓은 뮤즈 글리머는 정반대 방향 — 에이전트를 아예 폐쇄된 로컬 환경에 가둬 외부 인프라와의 접점 자체를 줄이는 접근입니다.
클라우드 에이전트의 자율성 확대와 로컬 실행을 통한 리스크 축소가 같은 시기에 같은 회사에서 동시에 진행되고 있다는 점은, 업계가 아직 에이전트 보안 문제에 한 가지 정답을 갖고 있지 않다는 방증이기도 합니다.
전망과 실무 시사점
뮤즈 글리머가 당장 챗GPT나 클로드를 대체하지는 않을 것입니다. 컴퓨터 사용 작업에서 큐원3.6에 뒤처진 결과가 보여주듯 아직 약점도 뚜렷하고, 24GB 이상의 VRAM을 갖춘 GPU 자체가 일반 사용자에게는 여전히 진입장벽입니다.
다만 메타가 멀티 에이전트 오케스트레이션 흐름에서 이미 확인됐듯 오픈AI·구글·앤트로픽 중심으로 짜여 있던 에이전트 생태계에 오픈소스 대안이 실사용 가능한 성능으로 들어왔다는 사실 자체가 의미 있는 변화입니다. 의료·금융 데이터처럼 외부로 내보내기 어려운 정보를 다루는 조직들이 오프라인 배포 가능한 에이전트 모델을 요구해온 흐름과도 맞닿아 있어, 이런 수요를 가진 기업들의 도구 선택지가 하나 늘었다고 보는 게 정확합니다.
지금 자동화·부업에 AI 에이전트를 쓰고 있다면 당장 할 수 있는 점검은 이렇습니다.
- 실행 빈도가 높은 워크플로우부터 비용 구조 재점검: n8n·Make 같은 자동화 도구에서 하루에도 수십~수백 번 반복 호출되는 노드가 있다면, 그 부분만 로컬 모델로 옮겼을 때 절감되는 API 비용과 GPU 구매·전기료를 비교해볼 만합니다. 실행 빈도가 낮다면 기존 유료 API가 여전히 더 경제적일 수 있습니다.
- 민감 데이터를 다루는 자동화는 로컬 실행 후보로 우선 검토: 계약서 초안, 미공개 콘텐츠, 고객 개인정보처럼 외부 전송이 부담스러운 작업부터 로컬 모델 적용을 시험해보는 편이 리스크 대비 효과가 큽니다.
- 양자화 버전과 하드웨어 사양을 먼저 확인: 도입을 고려한다면 보유한 GPU의 VRAM 용량(24GB 또는 32GB 기준)에 맞는 양자화 버전을 허깅페이스 모델 페이지에서 먼저 확인하고, 자신의 워크플로우와 비슷한 벤치마크(코딩이면 SWE-Bench, 도구 호출이면 MCP Atlas) 점수부터 비교하는 순서를 권합니다.
결국 뮤즈 글리머가 보여준 것은 “에이전트를 어디서 돌릴 것인가”라는 질문이 이제 성능과 비용, 데이터 주권을 함께 따져야 하는 실질적인 선택지로 넘어왔다는 사실입니다. 클라우드 API 하나로 모든 자동화를 해결하던 시기에서, 작업 성격에 따라 클라우드와 로컬을 나눠 쓰는 시기로 넘어가는 초입에 서 있다고 볼 수 있습니다.
핵심 요약
- 메타가 2026년 8월 10일 300억 매개변수 오픈소스 에이전트 모델 ‘뮤즈 글리머’를 공개했습니다. 4비트 양자화 버전은 24~32GB급 소비자용 GPU 한 장에서 오프라인으로도 실행됩니다.
- MCP Atlas·SWE-Bench Pro 등 도구 호출·코딩 벤치마크에서 젬마4-31B·큐원3.6-27B를 앞섰지만, 컴퓨터 화면을 직접 조작하는 작업에서는 아직 뒤처집니다.
- 실행 빈도가 높은 자동화의 반복 API 비용을 줄이고 민감 데이터를 외부로 보내지 않아도 된다는 점에서, 로컬 실행 가능한 오픈소스 에이전트가 자동화·부업 도구 선택지로 처음 현실화됐다는 데 의미가 있습니다.


AI 리서치와 검수 과정을 거쳐 콘텐츠를 제작합니다. 오류나 개선할 점을 발견하시면 연락처로 알려주세요.